MicroLED 光互连 面向AI基础设施的新一代I/O架构

阵列并行架构突破电互连物理极限,以光代电,赋能下一代AI算力基础设施。

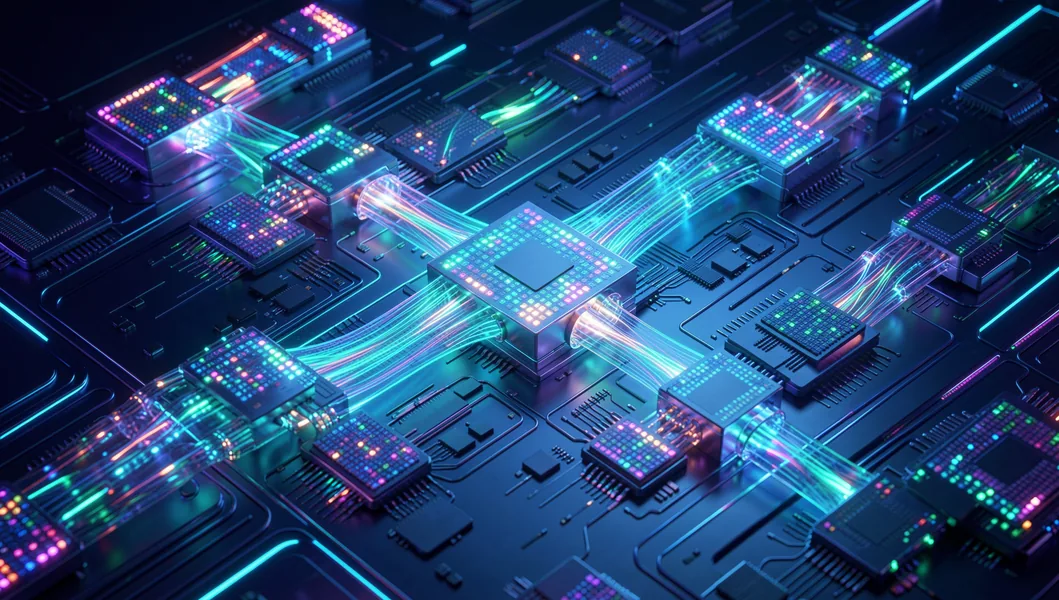
数据中心光互连渲染图 — MicroLED阵列光纤束
1Tbps to 100Tbps
超高聚合带宽
<1 pJ/bit
超低传输能耗
<1 ns
端到端延迟
  • 全链路验证
  • CMOS工艺兼容
  • 面向AI集群

阵列并行光互连架构

从单通道速率极限转向通道数量二维平方扩展,以光代电,突破电互连物理瓶颈

以光代电

突破铜缆物理极限,实现Tbps级聚合带宽
阵列并行

1000+通道线性扩展,单通道1–10 Gbps

CMOS兼容

16nm–130nm成熟工艺,供应链已验证

  1. 01

    MicroLED 阵列

    32×32 – 100×100

  2. 02

    微透镜耦合

    微米级对准

  3. 03

    多芯光纤束

    1000–10000芯

  4. 04

    PD阵列接收

    硅基PIN

100× 带宽提升
10× 能耗降低

性能数量级跃迁

阵列并行架构带来的根本性性能突破

技术指标对比

技术指标对比
技术指标 Array Photonics 传统电互连铜
聚合带宽 10–100 Tbps <1 Tbps
每比特能耗 <1 pJ/bit ~10 pJ/bit
端到端延迟 <1 ns 数百纳秒(含DSP)
带宽密度 1 Tbps/mm² 受限

多维优势

* 数据基于实验室原型验证

面向AI算力基础设施全栈覆盖

从节点内到集群骨干,全链路光互连解决方案

GPU光互连解剖图

节点内GPU互连

替代铜互连,Tbps级带宽,<1ns延迟,突破传统电互连方案的带宽天花板

光互连vs铜缆对比

板间 / 机架互连

光纤束替代铜缆,功耗降低10倍,布线体积减少70%,显著简化数据中心散热与布线复杂度

AI集群光互连架构

超算中心 / AI集群骨干

全光网络架构,支撑万卡级GPU集群高效互联,消除电互连瓶颈

全链路技术核心

覆盖发射端、耦合、传输、接收全链路环节,明确各模块性能目标

发射端

Proprietary IP
  • 32×32至100×100阵列
  • 单通道1–10 Gbps
  • Tbps级扩展能力

耦合

Proprietary IP
  • 微透镜阵列耦合
  • 微米级对准精度
  • 低插入损耗

传输

Proprietary IP
  • 1000–10000芯微光纤束
  • 纤芯直径 <10μm
  • 低串扰传输

接收

Proprietary IP
  • 硅基PIN PD阵列
  • 响应度 >0.4 A/W
  • 像素冗余设计, <10 FIT

系统级设计目标

  • 端到端延迟 <1 ns
  • 驱动能效 0.1 pJ/bit
  • 无需DSP

与行业领先封测厂商密切合作推进验证